
Integracje / Sentry
Komunikacja, projekty i biuro
Integracja AI: Sentry
Z Sentry podłączamy moduł Issues i Releases, żeby AI czytało pola users_count, culprit i first_seen każdego błędu. Asystent tłumaczy stack trace na jedno zdanie, wskazuje błędy blokujące największą liczbę użytkowników i wiąże incydenty z datą ostatniego deploymentu.
Po prezentacji do 2 tygodni testów, z dostępem tego samego dnia. Płacicie dopiero po decyzji.
W skrócie
Jak asystent AI łączy się z systemem Sentry?
Łączymy się z Sentry przez REST API przy użyciu User Auth Token, który generujecie w Settings > Auth Tokens. Do odczytu wystarczą uprawnienia org:read i project:read.
- Na start potrzebujemy
- User Auth Token z Sentry (Settings > Auth Tokens) z uprawnieniami org:read i project:read
- Czego asystent nie robi
- Nie zamyka Issues ani nie zmienia ich statusu w Sentry bez Waszego potwierdzenia w rozmowie.
- Gdzie są dane
- Na Waszym serwerze. Zaczynamy od odczytu, zapis włączacie sami.
Dane z Sentry w czacie i we własnym module
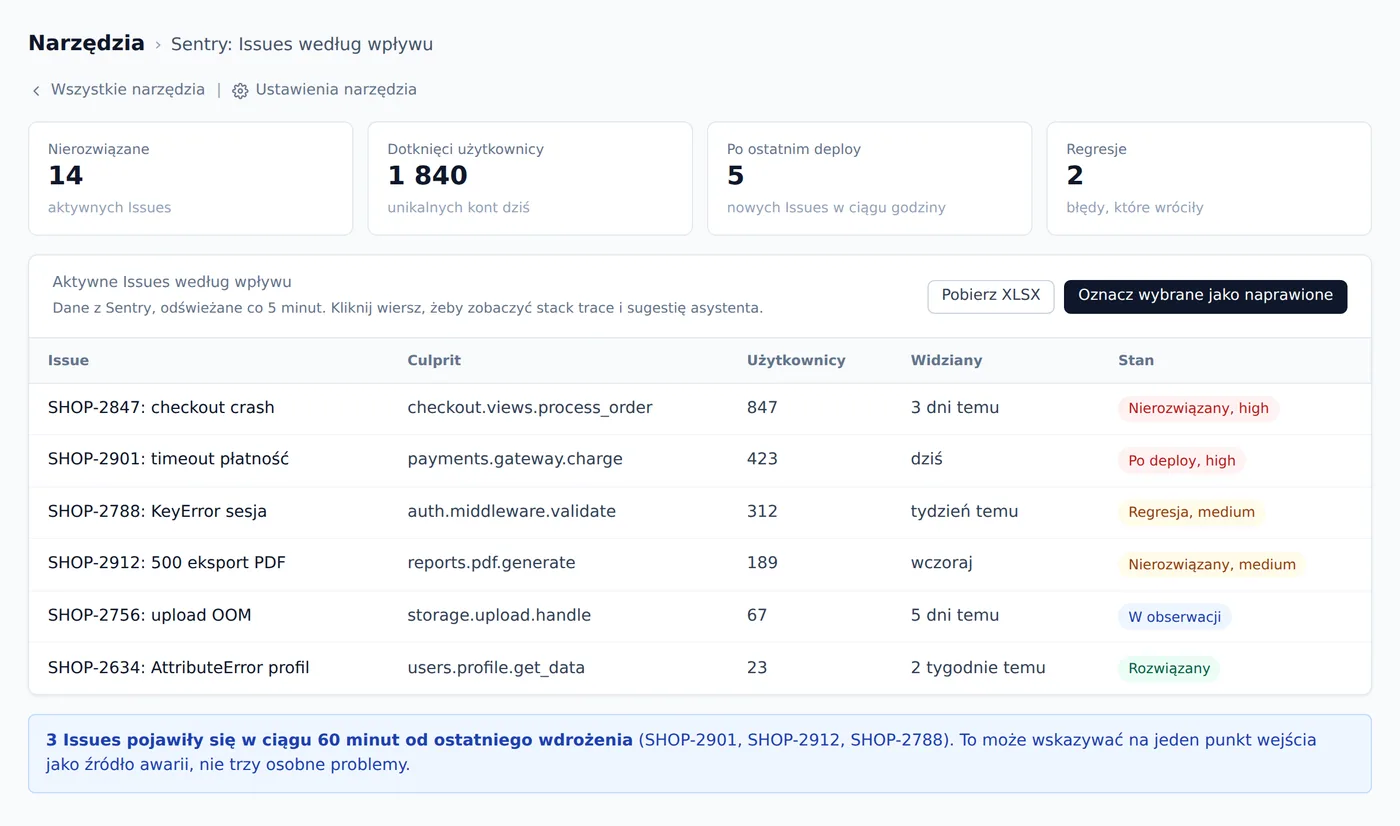
Pracujecie na dwa sposoby. W czacie pytacie o cokolwiek z programu i dostajecie odpowiedź na Waszych danych. Do rzeczy, które wracają co dzień, budujemy w portalu osobne narzędzie: Sentry: Issues według wpływu. Moduł pobiera aktywne Issues z Sentry i układa je według liczby dotkniętych użytkowników. Programiści i managerowie widzą w jednym miejscu, które błędy realnie blokują ludzi, kiedy każdy się pojawił i czy wiąże się z ostatnim wdrożeniem. Kliknięcie wiersza otwiera kartę z przetłumaczonym stack tracem i hipotezą asystenta.
- Sortuje Issues według pola users_count, nie według daty zgłoszenia
- Oznacza błędy, które pojawiły się w ciągu godziny od ostatniego deployu
- Wyróżnia regresje: błędy wcześniej oznaczone jako naprawione, które wróciły
- Tłumaczy pole culprit na czytelną nazwę modułu i funkcji w kodzie
- Pokazuje priorytet high, medium i low z Sentry jako kolorową odznakę stanu
Pytanie w czacie
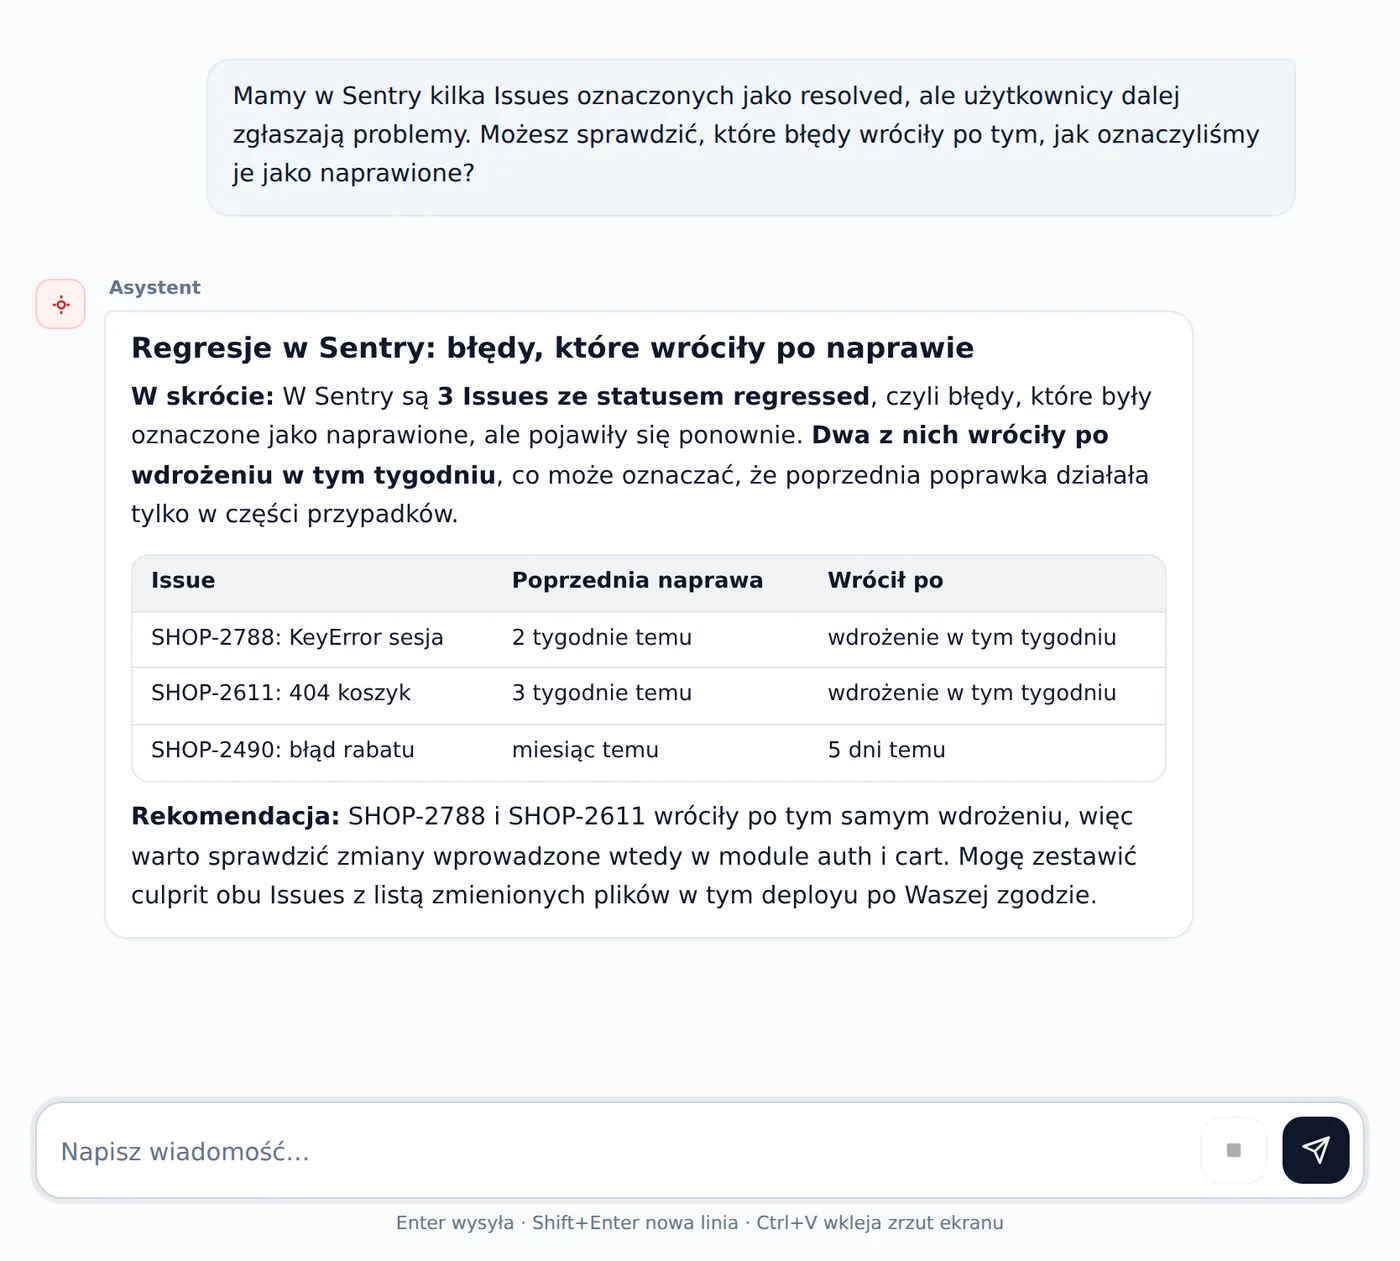
Asystent wyróżnia regresje jako osobną kategorię i łączy powrót błędu z konkretnym wdrożeniem, żeby programista wiedział, gdzie szukać cofniętej poprawki.
Mamy w Sentry kilka Issues oznaczonych jako resolved, ale użytkownicy dalej zgłaszają problemy. Możesz sprawdzić, które błędy wróciły po tym, jak oznaczyliśmy je jako naprawione?
Karta w narzędziu
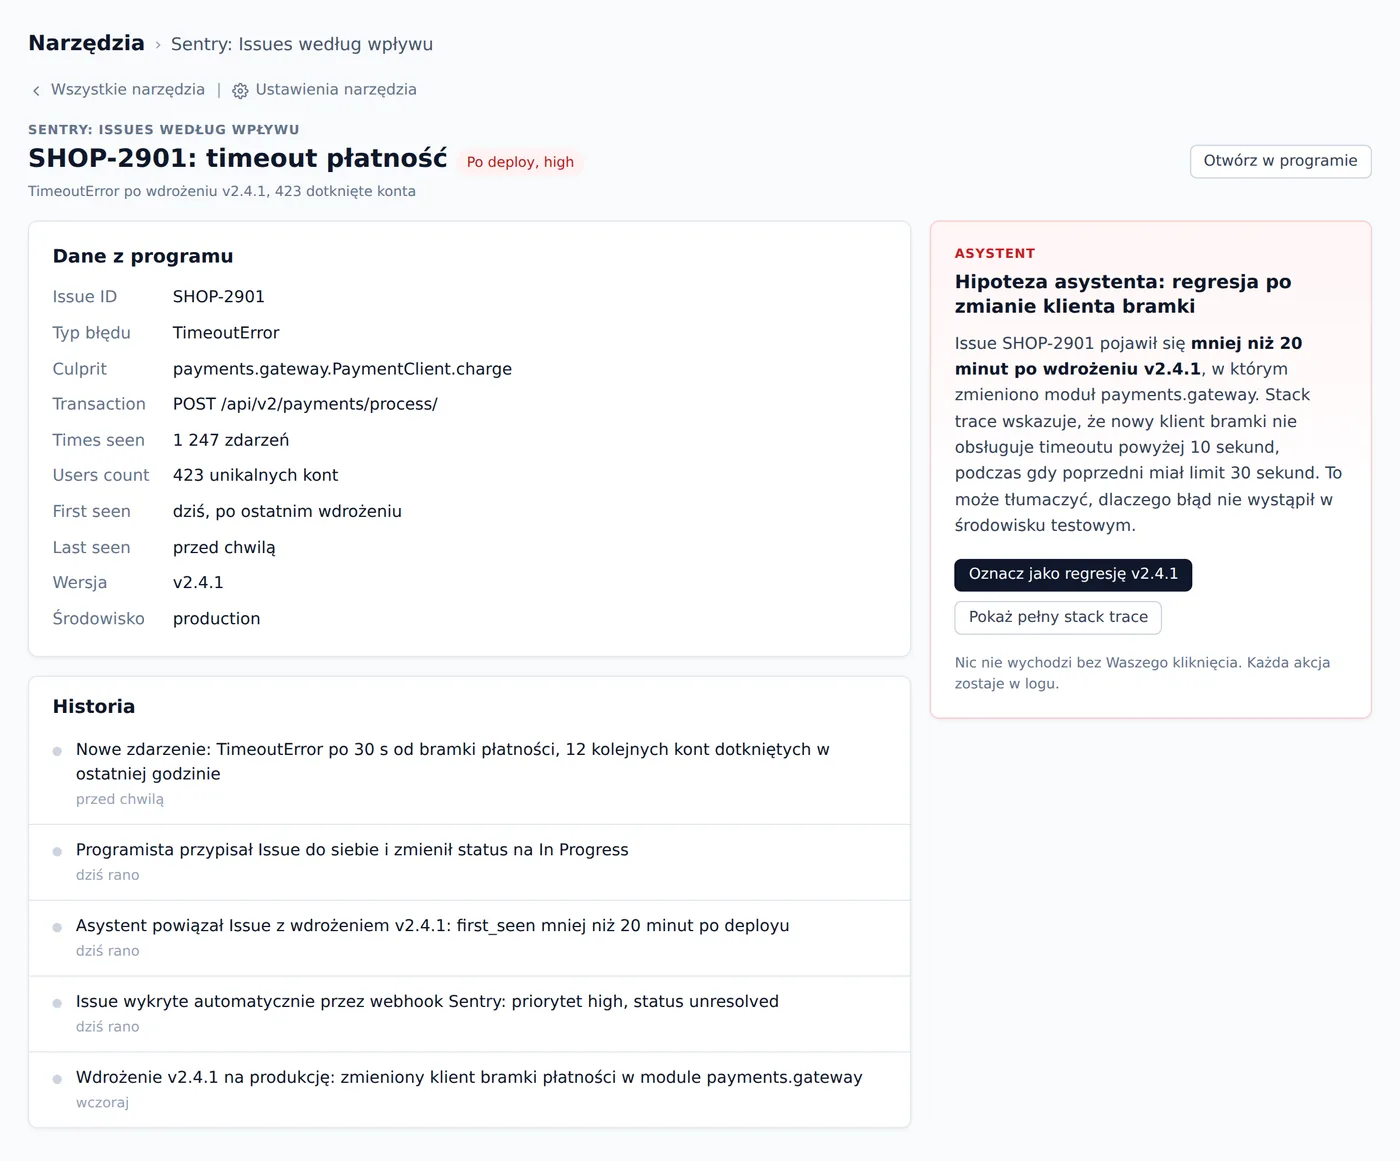
Karta rekordu łączy pola z Sentry, historię zdarzeń i hipotezę asystenta w jednym miejscu, żeby programista miał pełny obraz przed przystąpieniem do naprawy.
Moduł układa błędy według liczby dotkniętych użytkowników, nie według czasu zgłoszenia, i od razu pokazuje, które z nich pojawiły się tuż po wdrożeniu.
Ekrany na danych przykładowych. Narzędzie dla Waszej firmy układamy pod Wasz sposób pracy: inne kolumny, inne progi, inne powiadomienia.
Co podłączamy
Zaczynamy od odczytu danych. Zapis i akcje w systemie Sentry włączamy dopiero wtedy, gdy sami tego chcecie.
Czytamypola type, times_seen, last_seen i users_count dla każdego błędu, posortowane według liczby dotkniętych użytkowników
AsystentSortuje błędy według wpływu na użytkowników i wyróżnia te, które dotknęły największy odsetek aktywnych kont w ostatniej dobie, zamiast pokazywać po prostu najnowsze
Czytamylista wydań z tagami wersji i datami deploymentów z endpointu /api/0/organizations/{org}/releases/
AsystentPorównuje datę first_seen każdego błędu z datą ostatniego wdrożenia i wskazuje korelację jako hipotezę, gdy odstęp jest krótszy niż godzina
Czytamypełny stack trace, ścieżka wywołań i kontekst żądania HTTP z endpointu /api/0/issues/{issue_id}/events/latest/
AsystentTłumaczy stack trace na jedno zdanie i kategoryzuje błąd jako konfiguracyjny, timeout zewnętrznego API, błąd danych wejściowych albo błąd logiki biznesowej
Czytamyzdarzenie przy nowym Issue o statusie unresolved i priorytecie high, payload z polami first_seen i identyfikatorem Issue
AsystentUruchamia analizę natychmiast po nowym poważnym błędzie, bez czekania na ręczne sprawdzenie, i rozsyła wynik do wskazanej osoby
Czytamyślady żądań z polem transaction (nazwa trasy HTTP albo ekranu mobilnego) i czasem odpowiedzi dla każdego endpointu
AsystentGrupuje błędy według ścieżki URL i wskazuje, że kilka różnych Issue pochodzi z tego samego miejsca w aplikacji, to jeden punkt awarii, nie kilka osobnych problemów
CzytamyIssues ze statusem regressed, czyli błędów oznaczonych wcześniej jako naprawione, które wróciły po kolejnym wdrożeniu
AsystentWyróżnia powracające błędy jako osobną kategorię i sygnalizuje, że poprzednia naprawa zadziałała tylko częściowo lub nie zadziałała wcale
Czytamypole culprit z nazwą pliku i funkcji, gdzie błąd się pojawił, powiązane z polem transaction i ścieżką w aplikacji
AsystentŁączy różne Issue z tym samym miejscem w kodzie i pokazuje jeden punkt awarii zamiast kilku osobnych problemów do analizy
O co pytają w praktyce
Po polsku, jak koledze z pracy. Asystent odpowiada na danych z Waszego programu, a nie z ogólnej wiedzy.
- „Które błędy dotknęły dziś największą liczbę użytkowników?”
- „Czy dzisiejsze błędy pojawiły się po ostatnim wdrożeniu?”
- „Co oznacza ten stack trace i w którym miejscu kodu leży przyczyna?”
- „Które błędy wróciły po tym, jak oznaczyliśmy je jako naprawione?”
Co się zmienia
Zamiast ręcznego przeglądania Issues od rana zespół dostaje gotowe podsumowanie z priorytetem według wpływu na użytkowników i hipotezą przyczyny każdego błędu.
Asystent działa na Waszym serwerze, na Waszych uprawnieniach. Każdy odczyt i każda akcja zostawiają ślad w logu. Program zostaje tam, gdzie jest, razem z historią danych i nawykami zespołu.
O programie
Sentry to system do śledzenia błędów i wyjątków w aplikacjach webowych i mobilnych. Używają go zespoły programistyczne, które chcą wiedzieć, co psuje się na produkcji: kiedy po raz pierwszy pojawił się błąd, ilu użytkowników na niego trafiło i gdzie dokładnie w kodzie leży przyczyna. Codzienna praca wygląda tak: ktoś otwiera listę Issues rano, przebija się przez kilkadziesiąt pozycji i próbuje ocenić, co naprawić najpierw.
System grupuje każde zdarzenie w Issue z polami type, culprit, first_seen, last_seen, times_seen i users_count. Dane trzyma w chmurze sentry.io albo na własnym serwerze firmy, jeśli wybrała wariant self-hosted. Oprócz błędów Sentry śledzi wydania kodu i wiąże każde nowe Issue z konkretną wersją. Do tego dochodzą Performance Monitoring ze śladami żądań HTTP oraz Webhooks do reagowania na zdarzenia natychmiast po ich wystąpieniu.
Gdzie to działa najlepiej
Project manager
Poniedziałkowy poranek, sprint review za dwa dni. Otwiera Sentry i widzi czterdzieści nowych Issues od piątku. Nie jest programistą i nie wie, od czego zacząć ani które błędy realnie blokują użytkowników, a które to szum bez znaczenia.
Z asystentem: Asystent wskazuje trzy błędy, które dotknęły największy odsetek aktywnych użytkowników od piątku, tłumaczy każdy jednym zdaniem i sugeruje, który naprawić przed review.
Programista po wdrożeniu
Wdraża wersję 2.4.0 o 15:00. Pół godziny później Sentry pokazuje wzrost nowych Issues. Nie wiadomo, czy to błędy z tej wersji, czy istniejące wcześniej. Ręczne porównanie pola first_seen z datą deployu dla kilkudziesięciu rekordów zajmie godzinę.
Z asystentem: Asystent porównuje first_seen każdego nowego Issue z datą deployu i wydziela te, które pojawiły się po wdrożeniu. Programista dostaje gotową listę do sprawdzenia w kilka minut.
Właściciel firmy
Po incydencie, który zablokował checkout na czterdzieści minut, klient pyta o wyjaśnienie. Nikt nie napisał notatki podczas awarii. Sentry ma Issues z tamtego okna czasowego, ale nikt nie złożył z tego spójnej historii.
Z asystentem: Asystent zbiera Issues z okna incydentu, porównuje je z datą ostatniego wdrożenia i składa gotowy szkic: co się stało, kiedy błąd się pojawił i do której wersji to wróciło.
Jak się łączymy
Łączymy się z Sentry przez REST API przy użyciu User Auth Token, który generujecie w Settings > Auth Tokens. Do odczytu wystarczą uprawnienia org:read i project:read. Asystent wysyła zapytania do trzech głównych endpointów: lista Issues z filtrowaniem po statusie i sortowaniem, szczegóły zdarzenia z pełnym stack trace'em oraz lista wydań. Portal z plikami, bazami i historią rozmów stoi na Waszym serwerze. Do modelu AI trafia polecenie i przycięty fragment danych potrzebny do odpowiedzi, bez trenowania cudzych modeli na Waszych danych.
Tryb pracy to domyślnie odczyt: asystent nie zamyka Issues, nie zmienia statusów i nie modyfikuje ustawień w Sentry bez Waszego potwierdzenia. Webhooks działają w drugą stronę: Sentry wywołuje adres URL portalu, gdy pojawi się nowe Issue o wysokim priorytecie. Dzięki temu analiza może ruszyć natychmiast, bez harmonogramu odpytywanego co godzinę.
Czego potrzebujemy od Was
- User Auth Token z Sentry (Settings > Auth Tokens) z uprawnieniami org:read i project:read
- Dostęp do Project Settings > Integrations, jeśli chcecie uruchamiać analizę przez Webhook przy nowym błędzie
- Plan Team lub wyższy w Sentry do pełnego Performance Monitoring i śladów żądań HTTP
- Osoba z Waszego zespołu, która zna Sentry i może wygenerować token oraz wskazać projekty do podłączenia
- Ustalona retencja danych: darmowe konto zachowuje Issues przez 30 dni, pytania o starsze zdarzenia będą bez odpowiedzi
Czego asystent nie robi
- Nie zamyka Issues ani nie zmienia ich statusu w Sentry bez Waszego potwierdzenia w rozmowie.
- Nie naprawia kodu, który spowodował błąd. Wskazuje hipotezę przyczyny, a wdrożenie poprawki należy do programisty.
- Nie konfiguruje progów alertów ani reguł powiadomień w Sentry. Te zmiany robicie Wy w ustawieniach projektu.
- Powiązanie błędu z wdrożeniem to hipoteza oparta na czasie first_seen i dacie deployu, nie gotowy wyrok o przyczynie.
Częste pytania
Czy asystent widzi błędy ze wszystkich projektów naraz, czy tylko z wybranych?
Podłączamy projekty, które Wy wskazujecie na początku. Token API może mieć dostęp do całej organizacji, ale zakres analizy ustawiacie Wy: jeden projekt albo kilka. Przy dużej liczbie projektów warto zacząć od najważniejszego i rozszerzać stopniowo po pierwszych tygodniach pracy.
Mamy Issues, które od dawna ignorujemy. Czy asystent będzie o nich pisał codziennie?
Domyślnie asystent sortuje według users_count i first_seen, więc stare błędy z niskim users_count schodzą na dół listy. Możecie też przekazać listę Issues do pominięcia albo filtrować zapytania po statusie is:new. Konkretne reguły filtrowania ustalamy razem przy wdrożeniu.
Czy integracja działa też z Sentry Self-Hosted, który stoi na naszym serwerze?
Tak. Self-Hosted Sentry udostępnia te same endpointy REST API co chmura sentry.io. Różnica jest tylko w adresie bazowym zapytań: zamiast sentry.io wpisujemy adres Waszego serwera. Uprawnienia i sposób generowania tokenów są identyczne.
Czy asystent może samodzielnie zamknąć Issue albo ustawić nową regułę alertów w Sentry?
Nie robi tego bez Waszego potwierdzenia. Domyślny tryb to odczyt: asystent czyta dane i przygotowuje analizę. Zapis, czyli zmiana statusu Issue, ustawienie priorytetu czy modyfikacja reguł, zawsze wymaga jawnej zgody w rozmowie.
Jak zaczynamy
- Bezpłatna prezentacja. Mówicie, na czym pracujecie i co Was korkuje. Mówimy wprost, czy da się to spiąć, a jeśli nie ma czego automatyzować, też to powiemy.
- Do 2 tygodni testów. Dostęp do portalu tego samego dnia, podłączenie w trybie odczytu, sprawdzacie na własnych danych.
- Rozszerzanie. Kolejne moduły i akcje dokładamy, gdy zespół ufa temu, co dostaje. W abonamencie jest wdrożenie, integracja, szkolenie i opieka.
Pokażemy to na Waszych danych z Sentry
Jedno zdanie wystarczy: czego szukacie w Sentry albo co ma się dziać samo. Odpiszemy, co podłączymy i od czego zacząć.
Inne programy: komunikacja, projekty i biuro
Sentry jest znakiem towarowym swojego właściciela. Nie jesteśmy z nim powiązani ani przez niego autoryzowani. Nazwy używamy wyłącznie po to, żeby wskazać, z jakim programem integrujemy asystenta.