
Integracje / Zabbix i Grafana
Dokumenty i dane firmy
Integracja AI: Zabbix i Grafana
Podłączamy Zabbix API (trigger.get, event.get, history.get), adnotacje z Grafany i zapytania PromQL z Prometheusa. Asystent streszcza noc w jednym akapicie, grupuje alerty według wspólnej przyczyny i wypełnia szkic wpisu do rejestru incydentów.
Po prezentacji do 2 tygodni testów, z dostępem tego samego dnia. Płacicie dopiero po decyzji.
W skrócie
Jak asystent AI łączy się z systemem Zabbix i Grafana?
Do Zabbix łączymy się przez endpoint /api_jsonrpc.php kontem z rolą Zabbix User (Read-only w sekcji User roles). Wywołujemy metody trigger.get, event.get, history.get i host.get wyłącznie w trybie odczytu: żadnych zmian w triggerach, hostach ani konfiguracji.
- Na start potrzebujemy
- Konto read-only w Zabbix z rolą Zabbix User i dostępem do API na /api_jsonrpc.php
- Czego asystent nie robi
- Nie zmienia triggerów, hostów ani żadnych ustawień w Zabbix, nawet jeśli wykryje błędnie ustawiony próg alertu
- Gdzie są dane
- Na Waszym serwerze. Zaczynamy od odczytu, zapis włączacie sami.
Dane z Zabbix i Grafana w czacie i we własnym module
Pracujecie na dwa sposoby. W czacie pytacie o cokolwiek z programu i dostajecie odpowiedź na Waszych danych. Do rzeczy, które wracają co dzień, budujemy w portalu osobne narzędzie: Alerty Zabbix i Grafana. Moduł zbiera triggery i eventy z Zabbix API oraz adnotacje z Grafany i układa je w jeden widok dla administratora IT. Każdego rana zespół widzi, co zdarzyło się w nocy: które alerty wróciły do OK samoistnie, a które wciąż są aktywne i wymagają reakcji. Asystent grupuje zdarzenia według środowiska i wskazuje pierwotną przyczynę kaskady alertów.
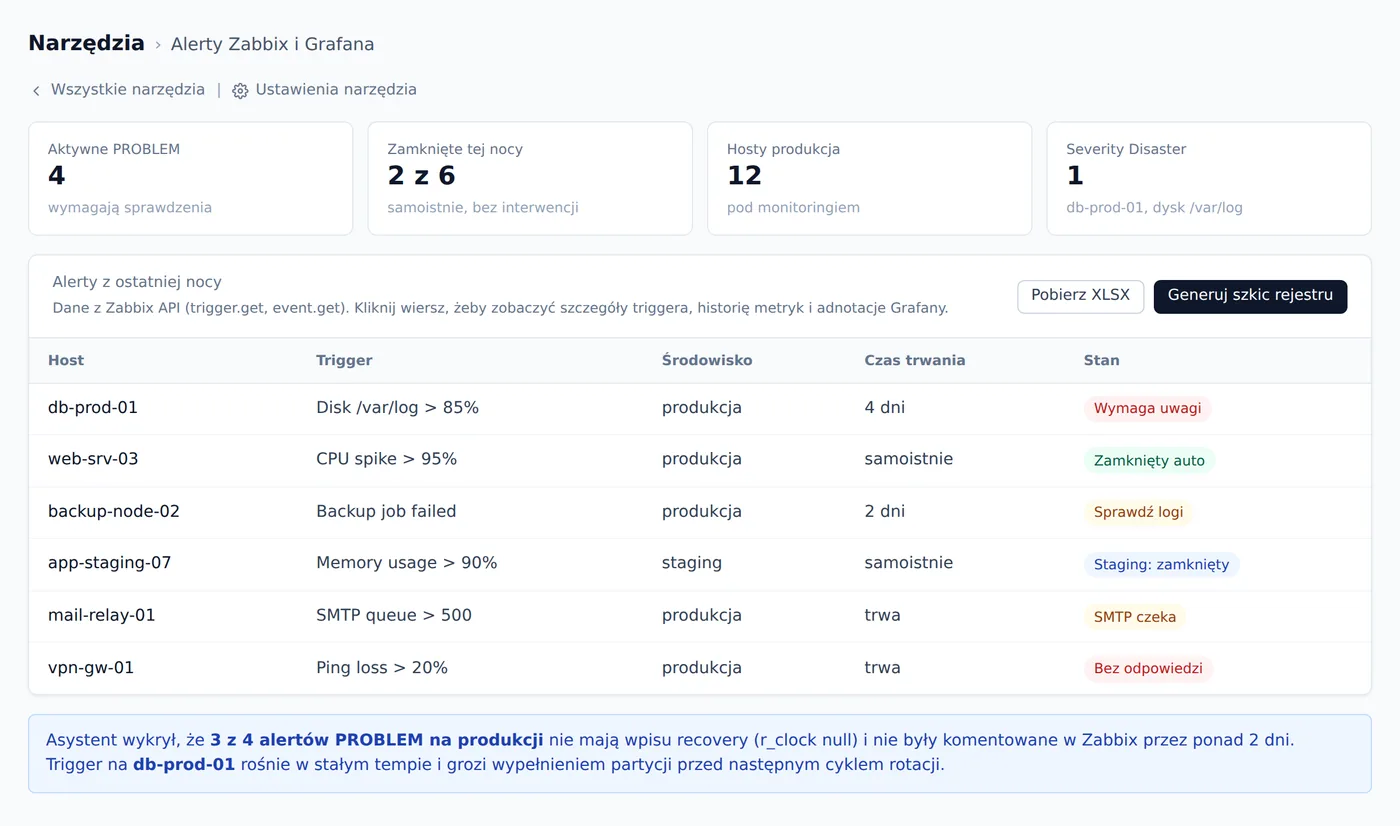
- Poranny raport nocnych triggerów z Zabbix: alerty aktywne i zamknięte samoistnie
- Grupowanie incydentów według środowiska: produkcja oddzielnie od stagingu
- Prognoza metryki z history.get: sygnał przed przekroczeniem progu triggera
- Szkic wpisu do rejestru: host, czas trwania i działania naprawcze z event.acknowledges
- Adnotacje Grafany dołączone do opisu: kontekst ludzki przy każdym incydencie
Pytanie w czacie
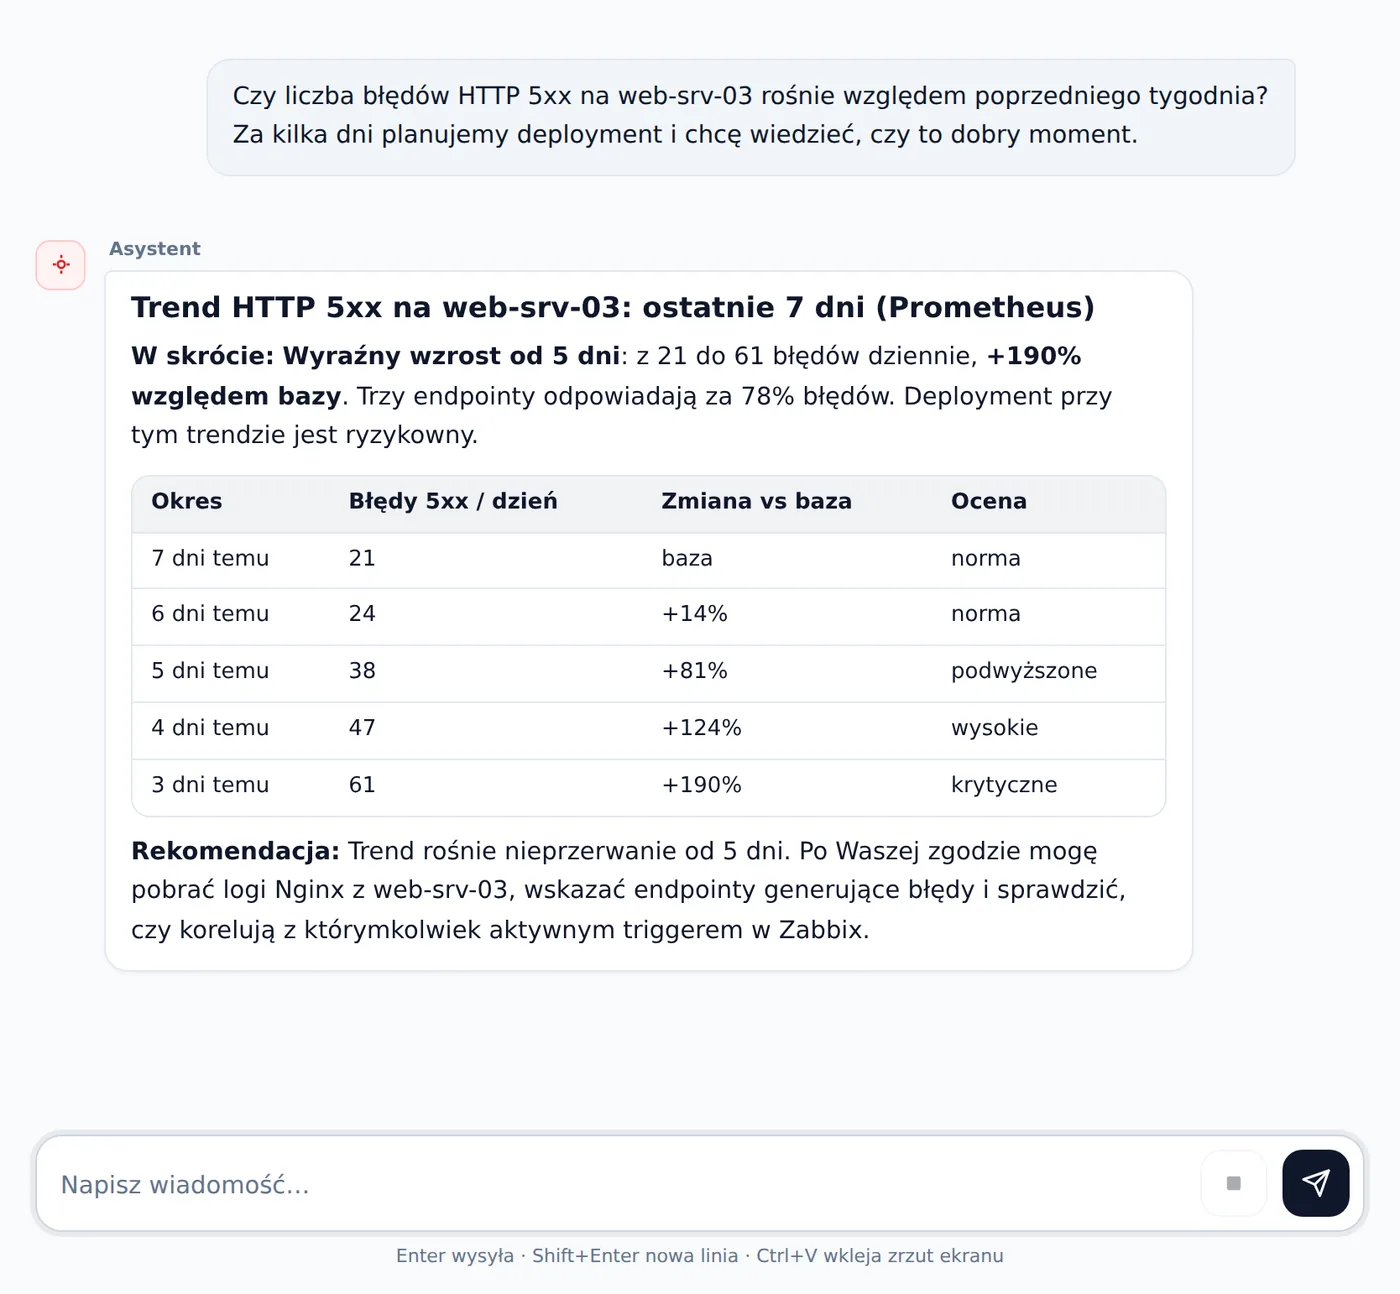
Pytanie o trend HTTP 5xx z Prometheusa przed deploymentem: asystent pobiera dane z /api/v1/query_range i wskazuje konkretny moment wzrostu, zanim jakikolwiek trigger w Zabbix zostanie wyzwolony.
Czy liczba błędów HTTP 5xx na web-srv-03 rośnie względem poprzedniego tygodnia? Za kilka dni planujemy deployment i chcę wiedzieć, czy to dobry moment.
Karta w narzędziu
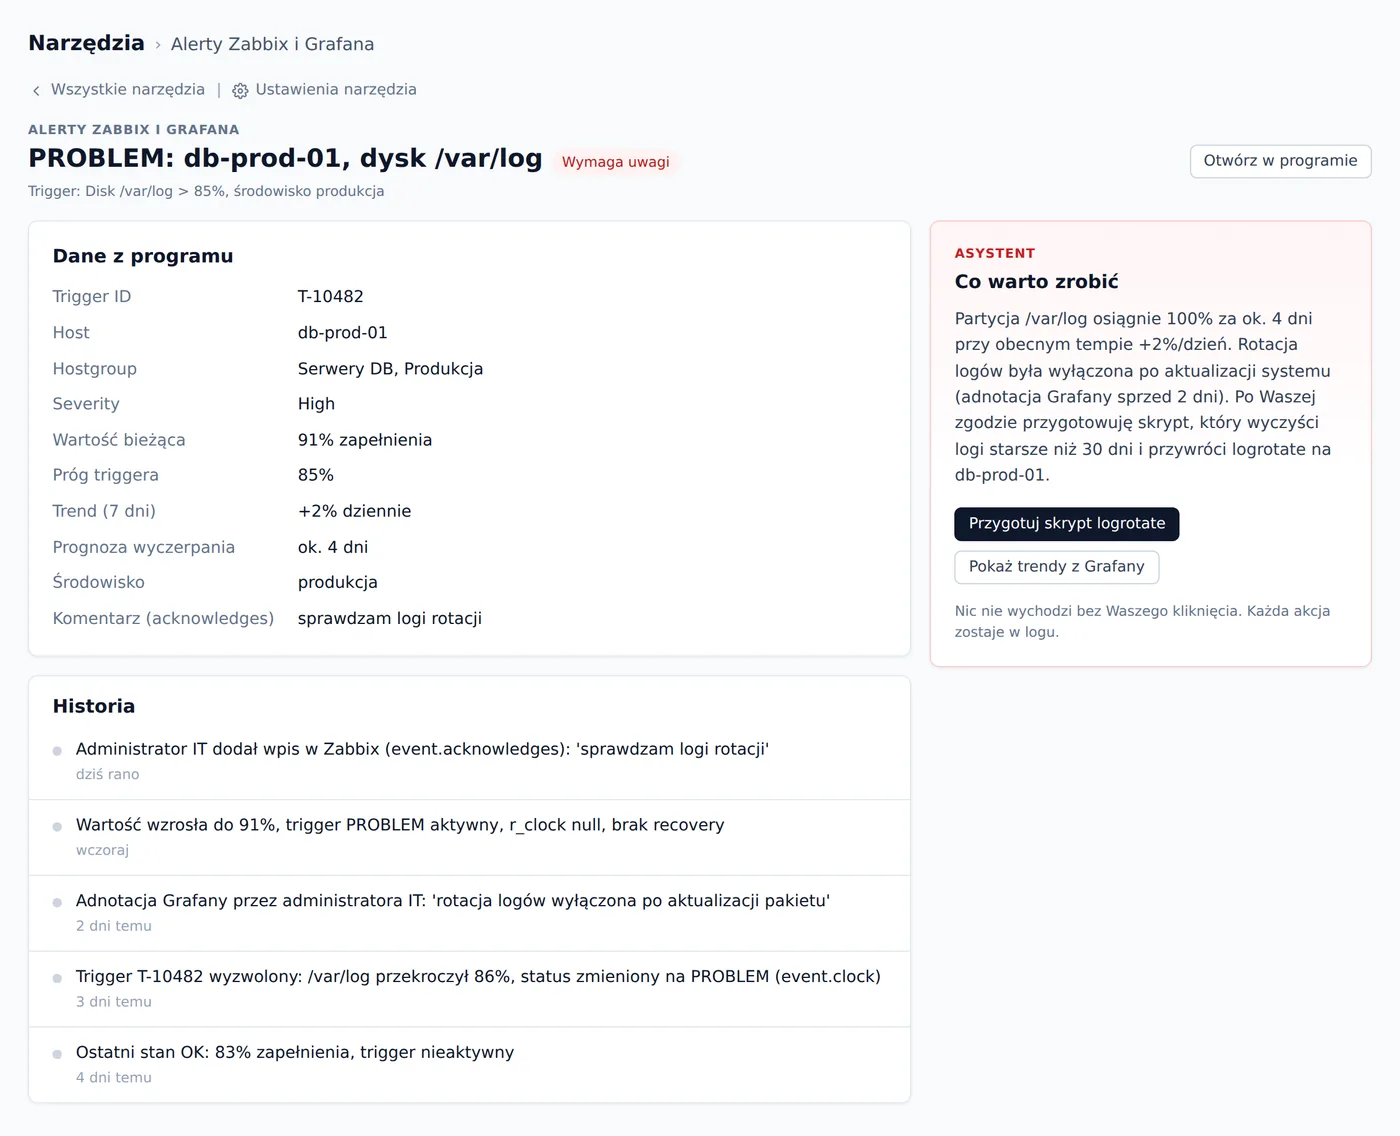
Karta incydentu z Zabbix: asystent łączy dane triggera z adnotacją Grafany i pokazuje prognozę opartą na history.get z 7 dni. Skrypt naprawczy czeka na zatwierdzenie przez administratora IT.
Poranny przegląd alertów z Zabbix w portalu redAi: administrator widzi stan wszystkich serwerów bez logowania do Zabbix, z automatycznym grupowaniem według środowiska i wskazaniem alertów wymagających uwagi.
Ekrany na danych przykładowych. Narzędzie dla Waszej firmy układamy pod Wasz sposób pracy: inne kolumny, inne progi, inne powiadomienia.
Co podłączamy
Zaczynamy od odczytu danych. Zapis i akcje w systemie Zabbix i Grafana włączamy dopiero wtedy, gdy sami tego chcecie.
CzytamyAktywne i zamknięte triggery z polami severity, status PROBLEM/OK i znacznikiem event.clock dla każdego zdarzenia
AsystentTworzy poranny raport z poprzedniej nocy, zaznacza, które triggery wróciły do OK samoistnie, a które wymagają uwagi
CzytamyWartości CPU, RAM i IOPS dysku z history.get za 30 dni z pełną rozdzielczością czasową
AsystentWykrywa metryki rosnące w stałym tempie i sygnalizuje ryzyko awarii, zanim skonfigurowany próg triggera zostanie przekroczony
CzytamyPola host.name i hostgroup.name z metody host.get, w tym podział na środowisko produkcyjne i staging
AsystentUzupełnia szkic rejestru incydentów nazwami dotkniętych systemów i grupuje alerty według środowiska, nie miesza produkcji ze stagingiem
CzytamyPole r_clock z eventów Zabbix oznaczające moment, w którym trigger przeszedł ze stanu PROBLEM do OK
AsystentWylicza czas trwania każdego incydentu i wstawia go automatycznie do pola 'Czas trwania' w szkicu wpisu do rejestru
CzytamyAdnotacje z endpointu /api/annotations i reguły alertów z /api/alerts, pobierane przez Service Account z rolą Viewer
AsystentWyciąga komentarze wpisane ręcznie przez administratora na wykres i dołącza je do opisu incydentu jako kontekst ludzki
CzytamyWyniki zapytań PromQL z /api/v1/query_range za dowolny przedział, w tym custom countery błędów HTTP 5xx
AsystentSprawdza, czy liczba błędów aplikacji lub czas odpowiedzi bazy rośnie tydzień po tygodniu, bez czekania na wyzwolenie triggera
CzytamyPole event.acknowledges zawierające wpisy administratora wpisane podczas ręcznej obsługi alertu w interfejsie Zabbix
AsystentPrzenosi opisane działania naprawcze do sekcji 'Działania naprawcze' szkicu rejestru incydentów, bez konieczności przepisywania
O co pytają w praktyce
Po polsku, jak koledze z pracy. Asystent odpowiada na danych z Waszego programu, a nie z ogólnej wiedzy.
- „Czy w nocy był jakiś poważny problem na serwerach produkcyjnych?”
- „Ile miejsca zostało na partycji /var/log i kiedy się skończy?”
- „Co wywołało kaskadę alertów wczoraj po północy?”
- „Czy rejestr incydentów za ten miesiąc jest kompletny?”
Co się zmienia
Administrator zamiast przeglądać dziesiątki maili z Zabbix dostaje rano gotowe streszczenie, pogrupowane przyczyny alertów i szkic wpisu do rejestru incydentów.
Asystent działa na Waszym serwerze, na Waszych uprawnieniach. Każdy odczyt i każda akcja zostawiają ślad w logu. Program zostaje tam, gdzie jest, razem z historią danych i nawykami zespołu.
O programie
Zabbix to platforma do monitorowania infrastruktury IT: zbiera metryki z serwerów, urządzeń sieciowych i aplikacji w tak zwanych items, a gdy któryś z nich przekroczy skonfigurowany próg, tworzy trigger i zapisuje event ze znacznikiem czasu w polu event.clock. Każdy event ma status PROBLEM lub OK oraz poziom severity: Information, Warning, Average, High lub Disaster. Grafana sama metryk nie zbiera, lecz łączy się ze źródłami takimi jak Prometheus, InfluxDB czy Zabbix i udostępnia dashboardy, reguły alertów i adnotacje.
Na co dzień administrator sprawdza wykresy w Grafanie, reaguje na alerty wysyłane mailem przez Zabbix i ręcznie przegląda zdarzenia z poprzedniej nocy. Dane Zabbix trafiają do bazy danych, najczęściej MySQL, PostgreSQL lub TimescaleDB. Prometheus przechowuje metryki jako szeregi czasowe na dysku serwera. Żadne z tych narzędzi nie grupuje alertów według przyczyny ani nie sygnalizuje, że dana metryka konsekwentnie rośnie od trzech tygodni.
Gdzie to działa najlepiej
Administrator IT
Przychodzi rano do biura i zamiast przeglądać kilkadziesiąt maili z Zabbix musi ocenić, czy w nocy cokolwiek wymagało interwencji. Przy spokojnej nocy i tak zajmuje to pół godziny.
Z asystentem: Asystent dostarcza jeden akapit z listą zdarzeń, wskazaniem pierwotnej przyczyny kaskady alertów i informacją, że wszystkie eventy zamknęły się samoistnie. Administrator decyduje w 20 sekund.
Kierownik techniczny
Przygotowuje miesięczne zestawienie incydentów dla zarządu i musi zebrać daty, czasy trwania i dotknięte systemy z ostatnich 30 dni. Rejestr jest niekompletny, bo wpisywanie go odkładano.
Z asystentem: Asystent generuje zestawienie na podstawie danych z Zabbix, z polami event.clock i r_clock, bez przekopywania archiwum maili. Kierownik weryfikuje, uzupełnia kontekst i zatwierdza.
Inżynier dyżurny
W środku nocy dostaje powiadomienie o pięciu równoczesnych alertach na różnych serwerach i musi ustalić, który z nich jest przyczyną, a które tylko reagują na problem na bazie danych.
Z asystentem: Asystent analizuje timeline eventów według pola event.clock i wskazuje hosta, na którym trigger zapalił się pierwszy. Diagnoza skraca się z kilkunastu minut do jednej minuty.
Jak się łączymy
Do Zabbix łączymy się przez endpoint /api_jsonrpc.php kontem z rolą Zabbix User (Read-only w sekcji User roles). Wywołujemy metody trigger.get, event.get, history.get i host.get wyłącznie w trybie odczytu: żadnych zmian w triggerach, hostach ani konfiguracji. W Grafanie zakładamy Service Account z rolą Viewer i tokenem wygenerowanym w jej ustawieniach. Prometheus nie wymaga autoryzacji w podstawowej konfiguracji, ale można go ograniczyć przez reverse proxy z tokenem Bearer.
Agent stoi na serwerze klienta, w tej samej sieci co Zabbix i Grafana. Pliki i bazy zostają na serwerze firmy, a do modelu trafia tylko to, co potrzebne do odpowiedzi, bez trenowania cudzych modeli na danych klienta. Odpytuje źródła cyklicznie co kilka minut albo reaktywnie po pojawieniu się alertu o severity High lub Disaster. Zapis jest możliwy tylko w docelowym miejscu raportu: Confluence, Notion, GLPI lub kanał Slack, i zawsze po zatwierdzeniu przez administratora.
Czego potrzebujemy od Was
- Konto read-only w Zabbix z rolą Zabbix User i dostępem do API na /api_jsonrpc.php
- Service Account z rolą Viewer w Grafanie i wygenerowany token dostępu
- Dostęp sieciowy do endpointu Prometheusa /api/v1/query_range, opcjonalnie z tokenem Bearer
- Osoba po stronie klienta znająca podział hostów na grupy i środowiska (produkcja / staging)
- Wskazane miejsce docelowe raportów: Confluence, Notion, GLPI lub kanał Slack do incydentów
Czego asystent nie robi
- Nie zmienia triggerów, hostów ani żadnych ustawień w Zabbix, nawet jeśli wykryje błędnie ustawiony próg alertu
- Nie wysyła raportów do żadnego miejsca bez wcześniejszego wskazania przez firmę kanału i formy zatwierdzenia
- Nie stawia diagnozy technicznej: wskazuje hipotezę na podstawie timeline'u, decyzję o naprawie podejmuje administrator
- Nie analizuje logów ani metryk z systemów, które nie eksportują danych do Zabbix, Grafany ani Prometheusa
Częste pytania
Czy integracja wymaga zmian w konfiguracji Zabbix lub Grafany?
Nie. Tworzymy tylko osobne konto z uprawnieniami Read w Zabbix i Service Account z rolą Viewer w Grafanie. Triggery, hosty, grupy, progi alertów i dashboardy pozostają bez zmian. Dla reszty zespołu korzystającego z Zabbix integracja jest niewidoczna.
Co asystent robi, gdy w nocy nie było żadnych alertów?
Wysyła krótki raport z informacją, że noc minęła bez zdarzeń o skonfigurowanym minimum severity. To też jest wartościowa informacja: administrator widzi, że system pracował i raport faktycznie dotarł, a nie że po prostu nic nie zgłoszono.
Czy asystent poradzi sobie z niestandardowymi triggerami firmy?
Tak. Agent czyta dane przez API niezależnie od tego, jak trigger jest skonfigurowany: własne progi, niestandardowe nazwy, firmowe szablony. Wszystko pojawia się w polach event.get i trigger.get. Może być potrzebna krótka kalibracja, żeby asystent wiedział, które hosty to produkcja, a które środowiska testowe.
Gdzie trafia szkic wpisu do rejestru incydentów?
To konfigurujemy przed uruchomieniem: może to być ticket w GLPI, strona w Confluence lub Notion, wiadomość na kanale Slack albo plik. Szkic zawsze czeka na zatwierdzenie przez człowieka. Żaden wpis nie pojawia się sam w rejestrze bez akceptacji administratora lub inżyniera dyżurnego.
Jak zaczynamy
- Bezpłatna prezentacja. Mówicie, na czym pracujecie i co Was korkuje. Mówimy wprost, czy da się to spiąć, a jeśli nie ma czego automatyzować, też to powiemy.
- Do 2 tygodni testów. Dostęp do portalu tego samego dnia, podłączenie w trybie odczytu, sprawdzacie na własnych danych.
- Rozszerzanie. Kolejne moduły i akcje dokładamy, gdy zespół ufa temu, co dostaje. W abonamencie jest wdrożenie, integracja, szkolenie i opieka.
Pokażemy to na Waszych danych z Zabbix i Grafana
Jedno zdanie wystarczy: czego szukacie w Zabbix i Grafana albo co ma się dziać samo. Odpiszemy, co podłączymy i od czego zacząć.
Inne programy: dokumenty i dane firmy
Zabbix i Grafana jest znakiem towarowym swojego właściciela. Nie jesteśmy z nim powiązani ani przez niego autoryzowani. Nazwy używamy wyłącznie po to, żeby wskazać, z jakim programem integrujemy asystenta.