
Integracje / Proxmox VE
Programy branżowe
Integracja AI: Proxmox VE
Podłączamy się do REST API Proxmox VE i Proxmox Backup Server przez token z rolą PVEAuditor. Asystent czyta statusy maszyn QEMU, zadania vzdump, zajętość datastore'ów i pole verification kopii w PBS, żeby informować o problemach zanim ktoś to zauważy w panelu.
Po prezentacji do 2 tygodni testów, z dostępem tego samego dnia. Płacicie dopiero po decyzji.
W skrócie
Jak asystent AI łączy się z systemem Proxmox VE?
Łączymy się z Proxmox VE przez REST API na porcie 8006 (HTTPS). Token tworzymy w panelu Datacenter -> Permissions -> API Tokens: format to użytkownik@realm!nazwaTokena, a sekret jest widoczny tylko w chwili tworzenia.
- Na start potrzebujemy
- Konto w Proxmox VE z rolą PVEAuditor i API token (Datacenter -> Permissions -> API Tokens)
- Czego asystent nie robi
- Asystent nie restartuje nieudanych zadań vzdump ani nie uruchamia kopii ręcznie: to decyzja administratora.
- Gdzie są dane
- Na Waszym serwerze. Zaczynamy od odczytu, zapis włączacie sami.
Dane z Proxmox VE w czacie i we własnym module
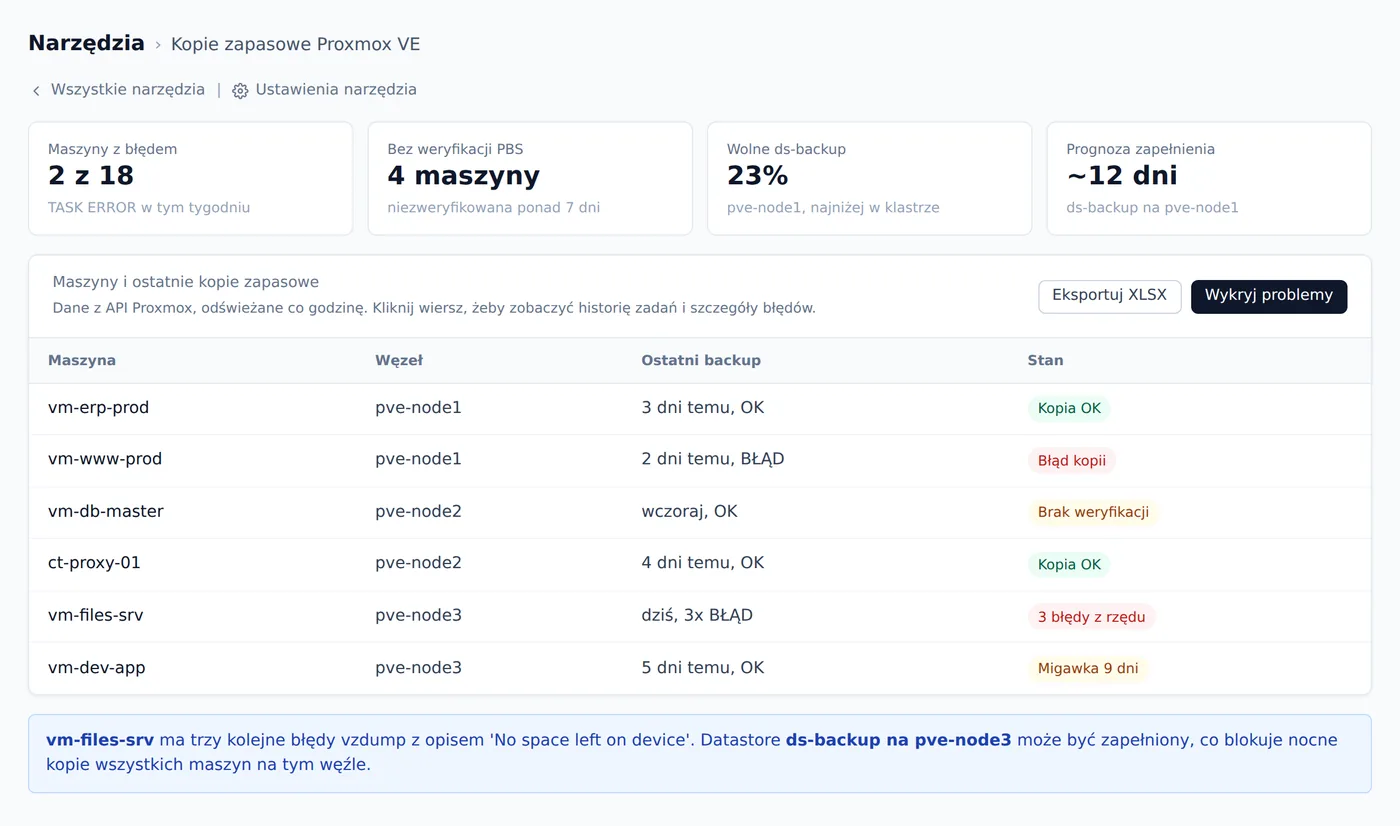
Pracujecie na dwa sposoby. W czacie pytacie o cokolwiek z programu i dostajecie odpowiedź na Waszych danych. Do rzeczy, które wracają co dzień, budujemy w portalu osobne narzędzie: Kopie zapasowe Proxmox VE. Moduł pobiera co godzinę wyniki zadań vzdump i stan datastore'ów ze wszystkich węzłów klastra przez token API z rolą PVEAuditor. Zespół widzi aktualne statusy kopii zapasowych bez logowania do panelu Proxmoxa. Asystent wykrywa serie błędów i prognozy zapełnienia zanim problem dotknie środowisko produkcyjne.
- Wyniki zadań vzdump dla każdej maszyny QEMU i LXC w klastrze
- Wykrywanie serii TASK ERROR dla tej samej maszyny (próg: 3 błędy z rzędu)
- Stan weryfikacji kopii w PBS z alarmem po przekroczeniu 7 dni bez weryfikacji
- Prognoza zapełnienia każdego datastore'u na podstawie tempa z ostatnich dni
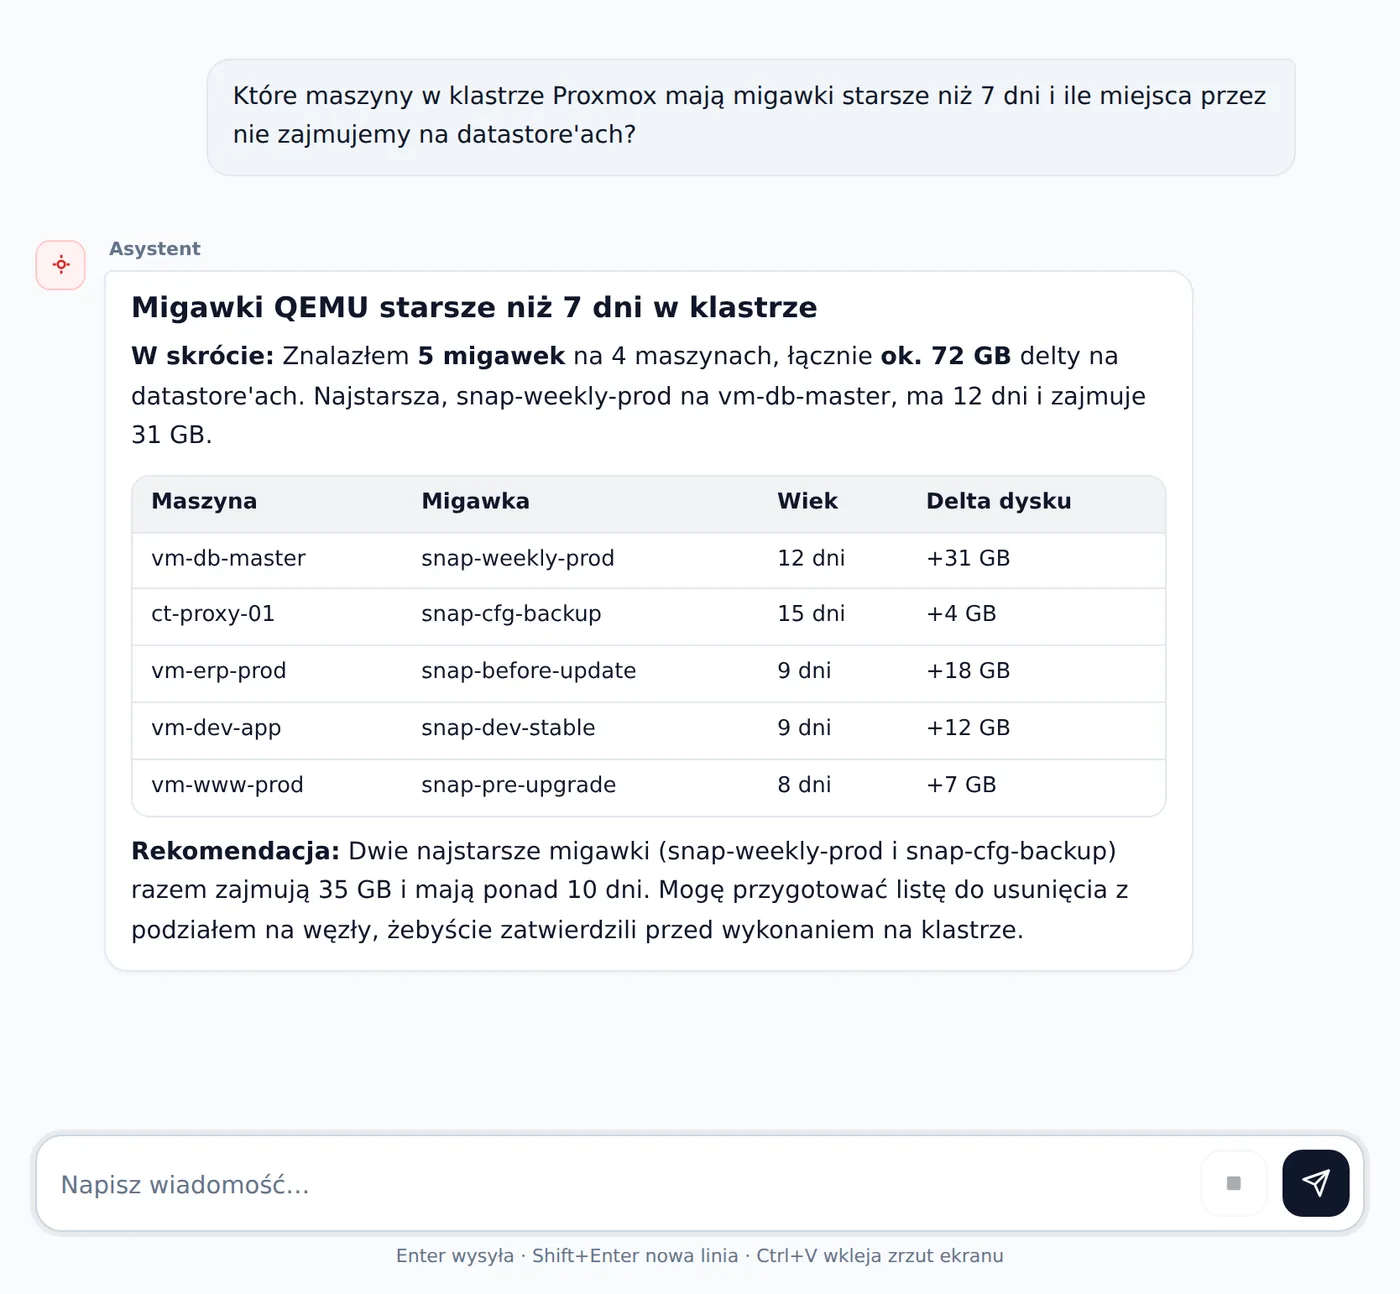
- Lista migawek QEMU starszych niż próg z szacowaną deltą zajętego miejsca
Pytanie w czacie
Administrator pyta o jedną linię, asystent przegląda cały klaster i zwraca gotową tabelę z wyliczoną deltą dysku. Usunięcie migawek trafia do Waszego zatwierdzenia, nie dzieje się automatycznie.
Które maszyny w klastrze Proxmox mają migawki starsze niż 7 dni i ile miejsca przez nie zajmujemy na datastore'ach?
Karta w narzędziu
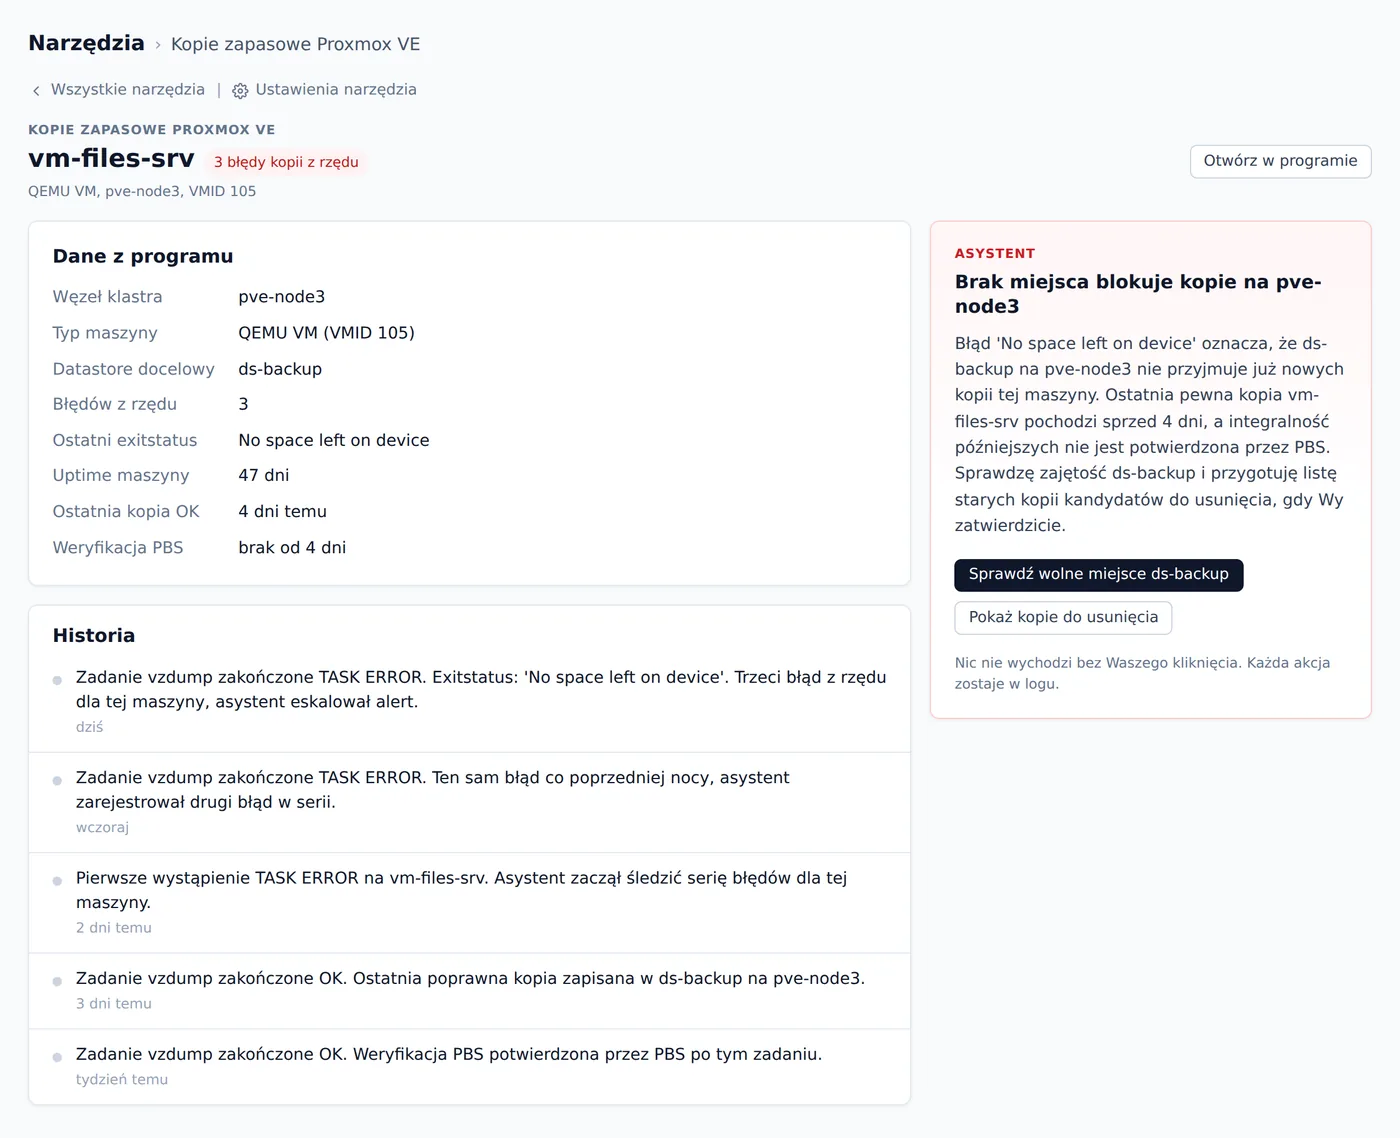
Karta jednej maszyny zbiera historię zadań vzdump, opis błędu i podpowiedź asystenta w jednym miejscu. Administrator widzi pełny kontekst bez przeszukiwania logów bezpośrednio na węźle.
Jeden ekran zastępuje ręczne przeglądanie logów na trzech węzłach klastra. Asystent zgłasza serie błędów i prognozuje zapełnienie datastore'ów, zanim problem przerwie nocne kopie.
Ekrany na danych przykładowych. Narzędzie dla Waszej firmy układamy pod Wasz sposób pracy: inne kolumny, inne progi, inne powiadomienia.
Co podłączamy
Zaczynamy od odczytu danych. Zapis i akcje w systemie Proxmox VE włączamy dopiero wtedy, gdy sami tego chcecie.
CzytamyStatus (running/stopped/paused), bieżące obciążenie CPU jako ułamek dziesiętny, zajęty i dostępny RAM w bajtach, rozmiar dysku, uptime
AsystentWykrywa maszyny zatrzymane poza planem serwisowym, długi uptime bez restartu i ponadprogowe obciążenie CPU utrzymujące się przez kilka dni z rzędu
CzytamyTyp zadania, status (OK lub TASK ERROR), czas startu i zakończenia, opis błędu z pola exitstatus
AsystentIdentyfikuje maszyny z trzema kolejnymi błędami kopii i tłumaczy opis błędu na zdanie zrozumiałe dla menedżera bez wiedzy technicznej
CzytamyPola used, avail i total dla każdego datastore'u na każdym węźle klastra
AsystentPorównuje odczyty z kolejnych dni, szacuje tempo zużycia i podaje prognozowaną liczbę dni do zapełnienia przy obecnym tempie
CzytamyPole snaptime każdej migawki, vmid i nazwa maszyny, nazwa migawki, endpoint /nodes/{node}/qemu/{vmid}/snapshot
AsystentWypisuje migawki starsze niż ustalony próg (np. 7 dni) z wiekiem i ostrzega, że rosnąca delta pliku dysku zajmuje miejsce na datastore
Czytamyvmid, backup-type (vm lub ct), backup-time jako timestamp uniksowy, rozmiar kopii i pole verification
AsystentWskazuje maszyny bez zweryfikowanej kopii dłużej niż tydzień i informuje, że integralność takich kopii nie jest potwierdzona przez PBS
CzytamyLogi zadań z filtrem type=vzdump i status=error, endpoint /nodes/{node}/tasks każdego węzła
AsystentŚledzi serię nieudanych prób dla tej samej maszyny i eskaluje alert po przekroczeniu ustalonego progu kolejnych błędów
O co pytają w praktyce
Po polsku, jak koledze z pracy. Asystent odpowiada na danych z Waszego programu, a nie z ogólnej wiedzy.
- „Która maszyna nie ma zweryfikowanej kopii od ponad tygodnia?”
- „Za ile dni zapełni się datastore ds-backup przy obecnym tempie?”
- „Które migawki mają ponad 7 dni i ile miejsca przez nie tracimy?”
- „Które zadania backup zakończyły się błędem w tym tygodniu i dlaczego?”
Co się zmienia
Firma dostaje codzienny raport o nieudanych kopiach, starych migawkach i zapełniających się datastore'ach, zanim administrator zauważy problem w panelu.
Asystent działa na Waszym serwerze, na Waszych uprawnieniach. Każdy odczyt i każda akcja zostawiają ślad w logu. Program zostaje tam, gdzie jest, razem z historią danych i nawykami zespołu.
O programie
Proxmox VE to platforma do wirtualizacji serwerów instalowana bezpośrednio na sprzęcie fizycznym. Organizuje infrastrukturę w trzech warstwach: węzły (fizyczne serwery w klastrze), maszyny wirtualne QEMU i kontenery LXC. Firmy instalują ją tam, gdzie chcą mieć własne serwery zamiast płacić za chmurę: w biurach, serwerowniach, u dostawców kolokacji. Administrator zarządza maszynami przez panel webowy, a te same dane są dostępne przez REST API w formacie JSON.
Proxmox Backup Server to osobny produkt, który firmy instalują obok VE do zarządzania kopiami zapasowymi. Dane trzymane są w datastore'ach, które mogą stać na wolumenie LVM-thin, ZFS, Ceph, NFS albo katalogu lokalnym. Zadania backup i zdarzenia klastra lądują w logach z polami statusu, czasu startu i zakończenia oraz opisu błędu. Historia kopii ma też pole weryfikacji integralności, dostępne przez REST API PBS na porcie 8007.
Gdzie to działa najlepiej
Administrator IT
Nocne kopie zapasowe głównych maszyn produkcyjnych przestały się wykonywać trzy tygodnie temu. Powiadamianie mailowe Proxmoxa nie działa, bo serwer SMTP ma stary adres IP po migracji. Nikt nie zaglądał do dashboardu PBS.
Z asystentem: Asystent wykrywa TASK ERROR pierwszego dnia i wysyła alert z opisem błędu i nazwą maszyny. Administrator reaguje tego samego ranka, zamiast dowiedzieć się o problemie dopiero przy awarii sprzętu.
Menedżer IT
Przełożony pyta o stan infrastruktury przed rocznym przeglądem. Menedżer musi zebrać dane o wynikach zadań backup z ostatnich 30 dni, stanie datastore'ów i historii migawek z trzech węzłów klastra.
Z asystentem: Asystent przygotowuje miesięczny raport: liczba backupów OK i TASK ERROR dla każdej maszyny, maszyny bez zweryfikowanej kopii, migawki starsze niż 7 dni. Raport gotowy bez ręcznego przeszukiwania logów PBS.
Administrator zarządzający dyskami
Datastore ds-backup ma 20% wolnego miejsca. Sam ten fakt nic nie mówi: administrator nie wie, czy zaplanowane kopie nocne się zmieszczą, ani kiedy datastore się zapełni przy obecnym tempie.
Z asystentem: Asystent podaje tempo zużycia z ostatnich dni i szacowaną liczbę dni do zapełnienia. Gdy nocna kopia historycznie zajmuje więcej niż dostępne miejsce, alert trafia do administratora przed wieczorem.
Jak się łączymy
Łączymy się z Proxmox VE przez REST API na porcie 8006 (HTTPS). Token tworzymy w panelu Datacenter -> Permissions -> API Tokens: format to użytkownik@realm!nazwaTokena, a sekret jest widoczny tylko w chwili tworzenia. W nagłówku HTTP przekazujemy go jako PVEAPIToken=... Rola PVEAuditor daje wyłącznie odczyt, bez możliwości zmiany konfiguracji ani uruchamiania zadań.
Proxmox Backup Server działa identycznie: REST API na porcie 8007, ten sam schemat tokenów, konfiguracja w PBS w sekcji Access -> Users -> API Tokens. Portal stoi na serwerze klienta. Skrypt odpytuje API Proxmoxa i PBS przez sieć wewnętrzną. Do modelu AI trafiają fragmenty danych potrzebne do analizy, bez dostępu do zawartości dysków wirtualnych ani wewnętrznych logów systemów operacyjnych maszyn.
Czego potrzebujemy od Was
- Konto w Proxmox VE z rolą PVEAuditor i API token (Datacenter -> Permissions -> API Tokens)
- Dostęp sieciowy z serwera portalu do portu 8006 Proxmox VE i portu 8007 PBS
- Konto i API token w Proxmox Backup Server, jeśli firma korzysta z PBS jako osobnego produktu
- Administrator po stronie firmy, który założy token i potwierdzi zakres dostępu przed uruchomieniem
- Bez dodatkowych licencji: API Proxmox VE działa w pełnym zakresie na wersji community, bez subskrypcji producenta
Czego asystent nie robi
- Asystent nie restartuje nieudanych zadań vzdump ani nie uruchamia kopii ręcznie: to decyzja administratora.
- Asystent nie usuwa migawek ani nie zwalnia miejsca na datastore'ach: informuje o stanie i sugeruje działanie.
- Asystent nie widzi zawartości dysków wirtualnych ani wewnętrznych logów systemów operacyjnych maszyn: czyta tylko metadane i statusy przez API.
- Asystent nie zmienia konfiguracji maszyn ani uprawnień w Proxmox: token ma wyłącznie dostęp do odczytu.
Częste pytania
Mamy klaster z kilkoma węzłami. Czy AI odpytuje każdy węzeł osobno?
Jeden token z rolą PVEAuditor na poziomie Datacenter wystarczy do całego klastra. Asystent odpytuje każdy węzeł po kolei przez API i łączy wyniki w jeden raport. Dostajecie widok całej infrastruktury, nie tylko jednego serwera.
Co dokładnie dostajemy w alercie, gdy backup się nie wykona?
Alert zawiera nazwę węzła, vmid maszyny, czas nieudanego zadania i opis błędu z pola exitstatus. Zamiast technicznego kodu błędu dostajecie zdanie zrozumiałe dla menedżera: co się stało, gdzie i co zrobić dalej. Trzy kolejne błędy dla tej samej maszyny to sygnał do eskalacji.
Co się stanie, jeśli węzeł klastra padnie i API nie odpowiada?
Gdy węzeł nie odpowiada, skrypt odnotowuje timeout i zaznacza ten węzeł w raporcie jako niedostępny. Dane z pozostałych węzłów trafiają do raportu normalnie. Alert o brakującym węźle idzie razem z pozostałymi wynikami, żebyście wiedzieli, że tamta część infrastruktury nie była sprawdzona.
Jak ustawiamy progi alertów, żeby nie dostawać zbędnych powiadomień?
Progi dla migawek, wolnego miejsca i liczby kolejnych błędów ustawiamy razem z firmą przed uruchomieniem, dopasowując je do jej środowiska i harmonogramu pracy. Alert zawiera konkretne wartości z API, nie ogólny komunikat, więc administrator od razu widzi, czy sytuacja wymaga działania.
Jak zaczynamy
- Bezpłatna prezentacja. Mówicie, na czym pracujecie i co Was korkuje. Mówimy wprost, czy da się to spiąć, a jeśli nie ma czego automatyzować, też to powiemy.
- Do 2 tygodni testów. Dostęp do portalu tego samego dnia, podłączenie w trybie odczytu, sprawdzacie na własnych danych.
- Rozszerzanie. Kolejne moduły i akcje dokładamy, gdy zespół ufa temu, co dostaje. W abonamencie jest wdrożenie, integracja, szkolenie i opieka.
Pokażemy to na Waszych danych z Proxmox VE
Jedno zdanie wystarczy: czego szukacie w Proxmox VE albo co ma się dziać samo. Odpiszemy, co podłączymy i od czego zacząć.
Inne programy: programy branżowe
Proxmox VE jest znakiem towarowym swojego właściciela. Nie jesteśmy z nim powiązani ani przez niego autoryzowani. Nazwy używamy wyłącznie po to, żeby wskazać, z jakim programem integrujemy asystenta.